AI
Evaluating Text-to-SPARQL Agents: Execution Accuracy, Coverage, and the Noise Floor
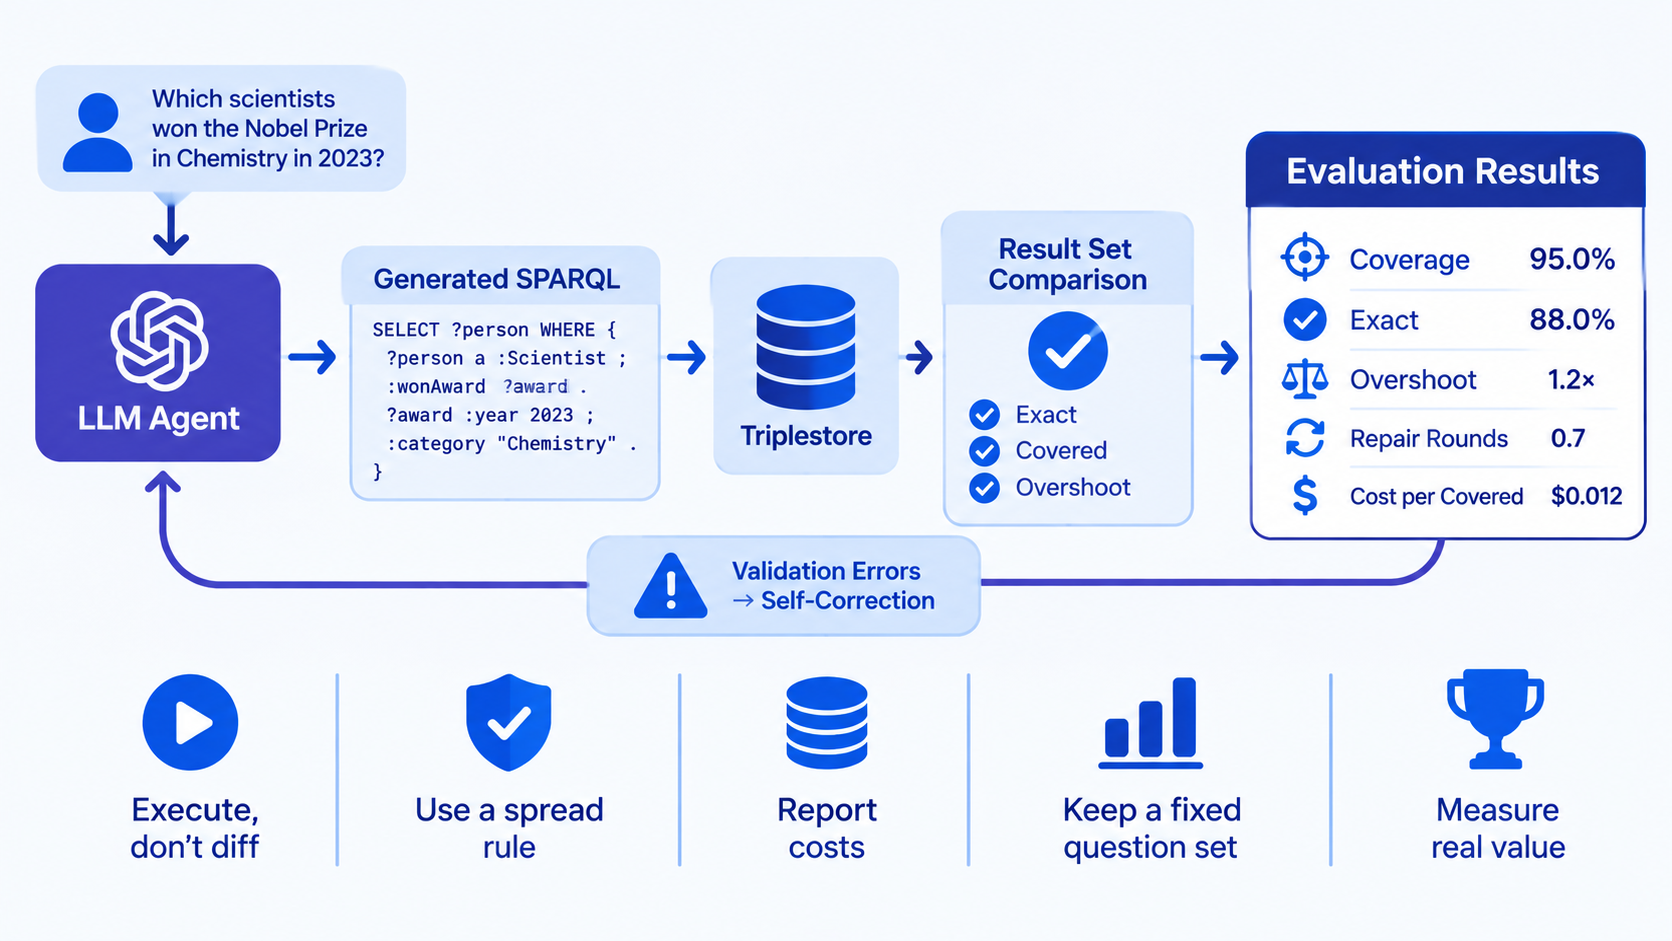
How do you compare LLMs on generating structured queries? Syntax similarity is worthless. What works: executing generated queries against a live triplestore and comparing result sets — plus a spread rule most benchmarks ignore.
5 min read